IBM酒类智能工厂顶层架构设计方案深度解读 数据处理服务的核心作用与实施蓝图
引言
随着工业4.0和智能制造的浪潮席卷全球,传统酒类制造业正面临前所未有的转型机遇。IBM凭借其在工业物联网、人工智能和企业级架构领域的深厚积累,推出了酒类智能工厂顶层架构设计方案,旨在帮助酒企实现从酿造、灌装到仓储物流的全链路智能化。在这一架构中,数据处理服务扮演着神经中枢的角色,负责将海量异构数据转化为可执行的洞察。本文将深度解读该方案中数据处理服务的架构设计、关键技术与实施路径。
一、酒类智能工厂的总体架构概览
IBM酒类智能工厂顶层架构通常分为五层:
- 设备层:包括酿造设备、发酵罐传感器、灌装线PLC、AGV、RFID标签等。
- 边缘层:部署边缘计算节点,实现低延迟数据预处理与实时控制。
- 平台层:核心为工业数据平台(IBM Cloud Pak for Data / IBM Maximo),提供数据采集、存储、治理、分析与AI能力。
- 应用层:涵盖生产排程、质量预测、能耗优化、供应链协同等智能应用。
- 生态层:与ERP、MES、WMS、CRM等系统集成,并连接上下游合作伙伴。
数据处理服务贯穿边缘层与平台层,是连接物理世界与数字孪生的桥梁。
二、数据处理服务的架构设计
2.1 总体设计原则
- 分层解耦:采集、传输、存储、计算、服务各环节独立扩展。
- 实时与批量结合:支持毫秒级流处理与大规模批处理。
- 混合云部署:兼顾数据主权与弹性算力。
- AI就绪:数据湖仓一体,支持机器学习与深度学习模型训练。
2.2 逻辑架构分层
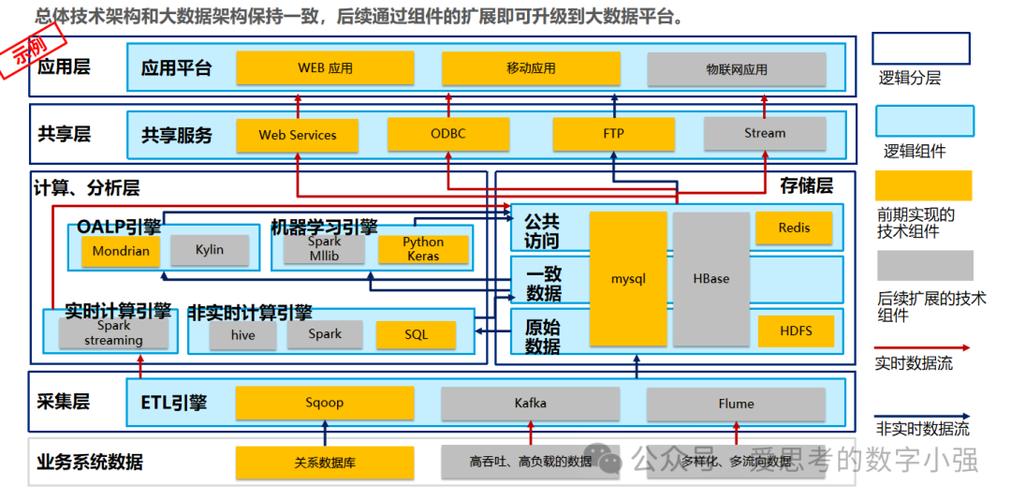
- 数据采集层
- 协议适配:支持OPC UA、Modbus、MQTT、Kafka、HTTP等工业协议。
- 边缘预处理:数据清洗、降采样、异常剔除、格式标准化。
- 采集方式:传感器直连、PLC集成、SCADA对接、人工录入APP。
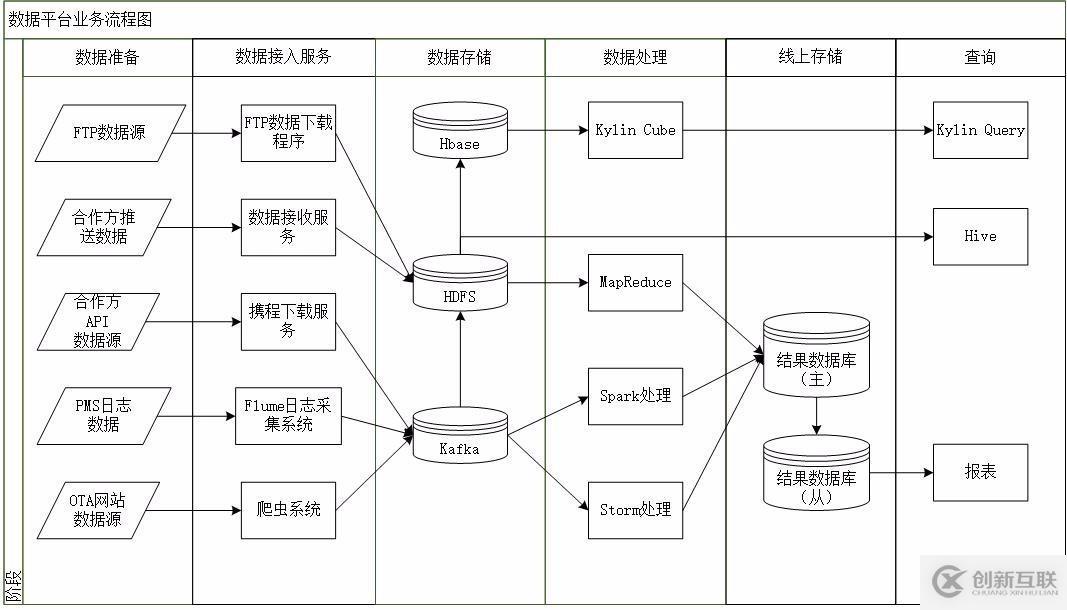
- 数据传输层
- 边缘到云:采用MQTT over TLS或Kafka Bridge,保证可靠传输。
- 消息队列:IBM Event Streams(基于Kafka)实现高吞吐、低延迟。
- 数据缓冲:边缘节点具备断网续传能力。
- 数据存储层
- 数据湖:IBM Cloud Object Storage,存储原始数据与历史归档。
- 数据仓库:IBM Db2 Warehouse,存储结构化业务数据。
- 湖仓一体:IBM Watson Query实现跨源虚拟化查询。
- 时序数据库:InfluxDB或IBM Db2 Time Series,存储传感器时序数据。
- 数据计算层
- 流计算:IBM Streams或Flink,用于实时监控、异常告警。
- 批计算:Spark on IBM Analytics Engine,用于历史分析与模型训练。
- 交互式分析:Watson Studio Notebooks,供数据科学家探索。
- 数据治理与服务层
- 元数据管理:IBM InfoSphere Information Governance Catalog。
- 数据质量:规则引擎与异常检测。
- 数据安全:加密、脱敏、访问控制、审计。
- API服务:API Connect将数据能力封装为微服务,供上层应用调用。
三、关键数据处理场景与实现
3.1 实时酿造监控
- 数据源:温度、湿度、pH值、糖度、压力等传感器。
- 处理流程:边缘节点每秒采集,流计算窗口聚合,实时判断是否偏离工艺曲线,触发Alert。
- 价值:防止发酵异常,提升出酒率与品质一致性。
3.2 灌装线质量检测
- 数据源:机器视觉图像、液位传感器、称重数据。
- 处理流程:边缘GPU推理缺陷检测,结果上传平台,批处理分析缺陷模式与设备参数关联。
- 价值:降低废品率,实现根因追溯。
3.3 预测性维护
- 数据源:设备振动、电流、温度、运行日志。
- 处理流程:时序数据存储,训练故障预测模型,实时评分并生成维护工单。
- 价值:减少非计划停机,延长设备寿命。
3.4 能耗与碳足迹优化
- 数据源:电表、水表、蒸汽流量计、产量数据。
- 处理流程:批处理计算单位产品能耗,AI模型推荐最优排产与设备启停策略。
- 价值:降本增效,满足ESG要求。
3.5 供应链溯源
- 数据源:原料批次、酿造记录、物流轨迹、销售数据。
- 处理流程:区块链或集中式账本记录关键事件,数据服务提供防伪查询API。
- 价值:保障品牌信誉,实现一瓶一码溯源。
四、技术选型与IBM产品映射
| 数据处理环节 | 推荐IBM产品 | 替代开源方案 |
|------------|------------|------------|
| 数据采集 | IBM Edge Application Manager | Node-RED, Telegraf |
| 消息队列 | IBM Event Streams | Apache Kafka |
| 流计算 | IBM Streams | Apache Flink |
| 数据湖 | IBM Cloud Object Storage | MinIO, HDFS |
| 数据仓库 | IBM Db2 Warehouse | ClickHouse, Snowflake |
| 数据治理 | IBM InfoSphere | Apache Atlas |
| AI平台 | IBM Watson Studio | JupyterHub, MLflow |
| API服务 | IBM API Connect | Kong, Spring Cloud Gateway |
五、实施路线图
- 阶段一:评估与规划(1-2月)
- 现状调研,定义数据源与业务目标。
- 设计数据架构蓝图,确定试点场景。
- 搭建边缘与云基础环境。
- 阶段二:试点建设(3-6月)
- 选择一条灌装线或一个发酵车间,部署数据采集与实时监控。
- 构建数据湖与流处理管道,验证数据质量。
- 开发1-2个智能应用(如异常告警、OEE分析)。
- 阶段三:全面推广(6-12月)
- 扩展至全厂区,集成MES、ERP。
- 完善数据治理与安全体系。
- 上线预测性维护、能耗优化等高级应用。
- 阶段四:持续优化(12月+)
- 引入AutoML与边缘AI,实现自学习。
- 构建数据中台,赋能生态创新。
六、挑战与应对
- 数据孤岛:通过统一数据模型与API网关打破部门壁垒。
- 实时性要求:采用边缘计算卸载云端压力,5G专网保障传输。
- 数据安全:实施零信任架构,对敏感配方数据加密存储与流转。
- 人才短缺:借助IBM专家服务与培训,建立内部数据科学团队。
##
IBM酒类智能工厂顶层架构设计方案中,数据处理服务不仅是技术支撑,更是业务创新的引擎。通过构建从边缘到云、从流到批、从治理到服务的完整数据链路,酒企能够实现更智能的酿造、更高效的运营和更透明的供应链。随着AI与物联网的深度融合,数据处理服务将持续演进,成为酒类行业数字化转型的核心竞争力。
(本文基于IBM公开技术资料与行业实践撰写,具体实施需结合企业实际需求定制。)
如若转载,请注明出处:http://www.honpuiot.com/product/51.html
更新时间:2026-09-19 18:58:59